Microsoft zal haar familie van Azure Maia AI-versnellers uitbreiden tot meerdere gigawatt implementaties vanaf 2027, met Maia 300 als nieuwe generatie infrastructuur voor het uitvoeren van modellen. De nieuwe chip maakt gebruik van een multi-chiplet architectuur, integreert high-bandwidth HBM4-geheugen en gebruikt het N2P-proces van TSMC in haar computationele chiplets. Het bedrijf streeft ernaar de inferentiecapaciteit te vergroten en het energieverbruik voor AI-diensten te verminderen.
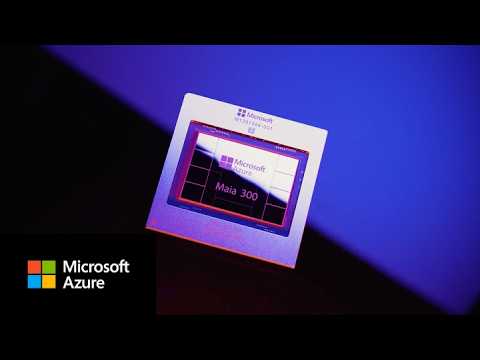
Kort overzicht van Maia 300 in 20 seconden
- Microsoft verwacht Maia 300 in productielijnen te lanceren in 2027 en de Maia-infrastructuur uit te breiden tot meerdere gigawatt.
- Elke versneller bevat acht stacks HBM4-geheugen, met 288 GB capaciteit en een maximale bandbreedte van 18 TB/s.
- Een rack bestaat uit 96 versnellers, met een gezamenlijke capaciteit van 27,6 TB HBM en een verwachte verbruik van maximaal 167 kW.
- Microsoft beweert dat Maia 300 tot 40% meer tokens per megawatt kan genereren dan referentiesystemen op basis van GPU.
- Maia 200 draait al in productie, inclusief voor Microsoft Copilot.
Deze aankondiging markeert een verschuiving in de infrastructuurstrategie van Microsoft: het bedrijf wil steeds meer afhangen van speciaal ontworpen versnellers voor hun eigen workloads, in plaats van uitsluitend te vertrouwen op algemene GPU’s. Het doel is het ondersteunen van taalmodellen, programmeerhulp en agent-systemen die grote hoeveelheden geheugen en rekenkracht vereisen over langere perioden.
De gepubliceerde prestatieresultaten komen van Microsoft en moeten gezien worden als door de fabrikant verklaarde uitspraken. Het bedrijf deelt niet alle referentiesystemen of een onafhankelijke methode om de resultaten onder gelijke omstandigheden te vergelijken.
Maia 300 combineert TSMC N2P-chiplets en HBM4-geheugen
Maia 300 is de derde generatie van Microsoft’s eigen acceleratorprogramma. Het ontwerp richt zich op inferentie, dat wil zeggen het uitvoeren van reeds getrainde modellen om antwoorden te genereren, instructies te verwerken of taken te voltooien. Deze activiteit vereist een balans tussen rekenkracht en datasnelheid naar de processoren toe.
Een van de belangrijkste elementen is het high-bandwidth HBM4-geheugen. Elke accelerator bevat acht stacks die 288 GB capaciteit bieden en tot 18 TB/s bandbreedte mogelijk maken, volgens de specificaties van Microsoft. De thermisch ontworpen verbruiksspecificatie ligt op 950 watt.
Het geheugen is bijzonder belangrijk bij het werken met extensieve contexten, lange gesprekken of taken met meerdere stappen. In zulke scenario’s kunnen datatransfers tussen geheugen en rekenunits de prestaties beperken, zelfs als de processor voldoende capaciteit heeft.
Microsoft zet tevens in op een chiplet-architectuur die berekeningsfuncties, geheugenchips en I/O-blokken scheidt. Deze organisatie maakt het mogelijk het ontwerp van elk onderdeel af te stemmen op specifieke prestatiewensen, connectiviteit en kosten.
De berekenings-chiplets maken gebruik van het N2P-proces van TSMC, een geavanceerde fabricagetechnologie. Microsoft deelt niet alle fysieke details van het silicium of de gegevens die nodig zijn voor een volledige vergelijking met andere commerciele accelerators.
Het ontwerp bevat ook lagere precisie numerieke formaten, waaronder een verbeterde MXFP4, om geheugen- en bandbreedte-eisen te reduceren. Daarnaast wordt SRAM-geheugen geïntegreerd in de chip, dat door software wordt beheerd als werkruimte, wat operationele accesses tot extern geheugen kan beperken.
De architectuur wordt verder versterkt door communicatie-structuren die gericht zijn op het verbinden van accelerators binnen een rack en tussen racks. Microsoft streeft ernaar dat datatransfer tussen rekenen, geheugen en netwerk onderdeel uitmaakt van één geïntegreerd uitvoeringssysteem, in plaats van communicatie-lagen te scheiden.
Racks van 167 kW voor toenemende AI-vraag
De referentieconfiguratie van Maia 300 bestaat uit 96 accelerators in een rack, met een limiet van 167 kilowatt. Het systeem bevat in totaal 27,6 TB HBM-geheugen en bereikt een totaal bandbreedte van 1,7 petabyte per seconde.
Deze cijfers beschrijven de gezamenlijke capaciteit van het systeem, niet die van één enkele chip. Geheugen en bandbreedte worden verdeeld over de accelerators en hangen af van de architectuur van de interconnectie en de workloads.
Het vermogen geeft ook een indicatie voor de fysieke eisen van de infrastructuur. Een rack zoals beschreven vereist een juiste elektrische en thermische planning, en een netwerk dat snel voldoende data kan overdragen. Microsoft benadrukt dat haar ontwerp gebruikmaakt van vloeistofkoeling om meer dan 80% van de thermische belasting af te voeren, inclusief de voedingseenheden en schakelingen. Geheugen, opslag en andere componenten worden gekoeld met lucht.
De connectiviteit combineert elektrische verbindingen binnen een rack met optische links tussen racks, volgens de door het bedrijf gepresenteerde architectuur. Het netwerkontwerp biedt schaalbaarheid van één rack tot grote clusters; Microsoft overweegt superpods met tot 12.288 versnellers verspreid over maximaal 128 racks.
De omvang van deze assembleringen helpt te verklaren waarom het systeemvermogen een belangrijke parameter is die Microsoft benadrukt. Het bedrijf beweert dat Maia 300 tot zeven keer meer tokens per rack kan genereren dan Maia 200, in een volledige configuratie van 96 versnellers. Daarnaast wordt een verbeteringspercentage van 40% in tokens per megawatt geschat ten opzichte van referentiesystemen op basis van GPU.
Deze cijfers zijn afkomstig van de fabrikant en betreffen geen gegarandeerde prestaties voor specifieke modellen of toepassingen. Eigenlijke resultaten kunnen variëren op basis van modelarchitectuur, contextlengte, numerieke precisie, geheugengebruik en operationele condities.
Maia 200 in productie en Maia 300 vanaf 2027
Microsoft maakt onderscheid tussen de reeds gebruikte infrastructuur en de komende generatie. Maia 200 is in productie en voert interne workloads uit, waaronder Microsoft Copilot, en ondersteunt het team dat eigen MAI-modellen ontwikkelt. Daarnaast heeft het bedrijf aangekondigd dat GitHub Copilot en Microsoft Foundry Maia 200 zullen gaan inzetten vóór het einde van 2026.
De ervaring met Maia 200 heeft geleid tot het ontwerp van Maia 300. Microsoft ziet toepassingen in programmeerhulp, cloud-gebaseerde modellen, data-generatie voor training en ontwikkeling en klinische toepassingen zoals Dragon Copilot.
Volgens Microsoft levert Maia 200 tot 1,7 keer meer tokens per watt op dan referentie GPU-infrastructuur in bepaalde AI-functies die geïntegreerd zijn in Microsoft Teams, Copilot en Cowork-ervaringen. Deze cijfers betreffen de beschreven workloads en moeten niet worden verward met prestatievergelijkingen voor Maia 300 per megawatt.
De uitrol van Maia 300 start in 2027. Daarnaast plant Microsoft om de Maia-generatie op te schalen tot meerdere gigawatt vanaf dat jaar, hoewel het geen gedetailleerd schema of distributie per datacenter of regio geeft.
De strategie betekent niet dat alle diensten van Microsoft afscheid nemen van GPU’s van andere fabrikanten. Het doel is Maia te positioneren als het primaire inference-systeem voor de producten en diensten van het bedrijf, zonder een volledige vervanging van externe accelerators af te dwingen.
Voor Azure-klanten biedt de ontwikkeling van Maia meer infrastructuuropties voor het uitvoeren van modellen en AI-toepassingen. Invloeden op prijzen, beschikbaarheid of prestaties hangen af van hoe Microsoft de nieuwe systemen inzet en welke zakelijke voorwaarden wordt ingesteld.
Veelgestelde vragen
Wanneer komt Microsoft Maia 300 beschikbaar?
Microsoft verwacht de uitrol van Maia 300 in 2027 te starten. Een specifieke datum voor algemene beschikbaarheid is nog niet aangekondigd.
Welke geheugen- en bandbreedteisère heeft Maia 300?
Elke accelerator heeft 288 GB HBM4-geheugen en een maximale bandbreedte van 18 TB/s. Een rack met 96 accelerators bevat in totaal 27,6 TB geheugen.
Welk fabricageproces gebruikt Maia 300?
De computationele chiplets maken gebruik van het N2P-proces van TSMC. Het ontwerp scheidt berekening, geheugenchips en I/O-functies in aparte chiplets.
Wat is het verschil tussen Maia 200 en Maia 300?
Maia 200 draait al in productie en wordt gebruikt voor Microsoft’s interne workloads. Maia 300 is ontworpen om inferentie te verbeteren voor taken met grote geheugenseisen en uitgebreide contexten. Microsoft beweert dat Maia 300 tot zeven keer meer tokens per rack kan verwerken dan Maia 200 in een configuratie van 96 accelerators.